MAI-DxO від Microsoft обійшов лікарів загальної практики в дослідженні в Science
У журналі Science описали MAI-DxO від Microsoft: 83% правильних діагнозів у складних випадках NEJM проти 36% у лікарів, ще й за менших витрат на аналізи.
Редакція LandGadget · · 3 хв читання
Діагностична ШІ-система Microsoft пройшла рецензування. У статті, яку 22 жовтня опублікував журнал Science, ідеться, що MAI-DxO значно частіше за лікарів загальної практики ставила правильний діагноз у складних клінічних випадках і водночас обирала дешевші набори аналізів. Керівник Microsoft AI Мустафа Сулейман у розмові з TechCrunch назвав це кроком до «медичного суперінтелекту».
Як працює MAI-DxO
Більшість медичних тестів для ШІ дають моделі охайно складений опис випадку й просять відповідь. Команда Microsoft створила бенчмарк SDBench, який більше схожий на справжній прийом. Система або лікар отримують лише коротку скаргу пацієнта й самі вирішують, які запитання ставити та які аналізи призначати, а кожен аналіз має орієнтовну вартість.
MAI-DxO — це оркестратор поверх великих мовних моделей. Microsoft описує його як консиліум віртуальних лікарів: кілька агентів пропонують діагнози, обирають корисні запитання чи аналізи й сперечаються між собою кілька раундів. Потім система зважує, наскільки кожен аналіз корисний порівняно з його ціною.
Результати
- Складні випадки: на 304 клініко-патологічних випадках із New England Journal of Medicine MAI-DxO набрала 83,2%. Лікарі загальної практики впоралися в 36% випадків із підручниками та інтернетом і в 22% — без них.
- Звичайні невідкладні стани: на випадках з приймального відділення з бази MIMIC-IV-ED система набрала 80,3% проти 46,8% у лікарів, тобто приблизно в 1,7 раза більше.
- Вартість: в ощадливому режимі точність становила 80,9% при середній орієнтовній вартості аналізів $2241, тоді як найточніший режим без обмежень коштував $5431.
За словами Microsoft, підхід не прив'язаний до однієї моделі. Основні прогони в статті робили з GPT-5, а з новішими моделями, зокрема GPT-5.5, результати, як стверджує компанія, збереглися й навіть покращилися. Частину SDBench для вибраних випадків NEJM компанія відкриває, щоб інші дослідники могли перевірити висновки.
Застереження
Автори чесно описують обмеження. Лікарі в дослідженні працювали поодинці й були терапевтами, а не профільними фахівцями чи командами, які зазвичай ведуть такі складні випадки. Бенчмарк лише текстовий, без знімків і гістологічних препаратів, і в кожному випадку була хвороба, тож вибірка не схожа на звичайну поліклініку. Вартість рахували за стандартними цінами США. І головне: дослідження оцінювало тільки діагностику, а не лікування, безпеку чи наслідки для пацієнтів.
Наша думка
Це вагоміший результат, ніж складений чат-ботом тест із варіантами відповідей, бо система мусила сама обирати аналізи. Проте це все ще бенчмарк, а не клінічне випробування. Наступний справжній рубіж — проспективне дослідження в лікарнях, де рішення ухвалюють лікарі. А доти користуйтеся чат-ботами для питань про здоров'я обережно й перевірте, що вони роблять із вашими даними. Більше про власні моделі Microsoft — у нашому матеріалі про MAI-Base-2, а про те, як незалежні тестувальники перевіряють ШІ, читайте в новині про доступ METR до моделей Anthropic.
Часті запитання
Чи можу я сам скористатися MAI-DxO?
Ні. Microsoft описує її як дослідницьку систему й не анонсувала продукту для пацієнтів чи лікарів. Частину бенчмарку SDBench відкривають для дослідників.
ШІ переміг профільних фахівців?
Ні. Його порівнювали з окремими лікарями загальної практики. Автори очікують, що проти фахівців відповідного профілю різниця буде меншою.
Більше: Комп'ютери та ШІ
Усі →Читайте далі
Cyberpunk 2077 2.5: стрільба з двох рук, моди та квест за Edgerunners 2
Безкоштовне оновлення Edgerunners 2 (2.5) від CD Projekt Red: пістолети в обох руках, кросплатформні моди через mod.io, стилі кіберімплантів і квест-приквел до аніме.
Як розпізнати підроблений застосунок у Google Play до встановлення
Фальшиві WhatsApp, Chrome і банківські застосунки потрапляють у Google Play. Перевірки, що викривають клон: розробник, завантаження, відгуки, реклама, дозволи, Play Protect.
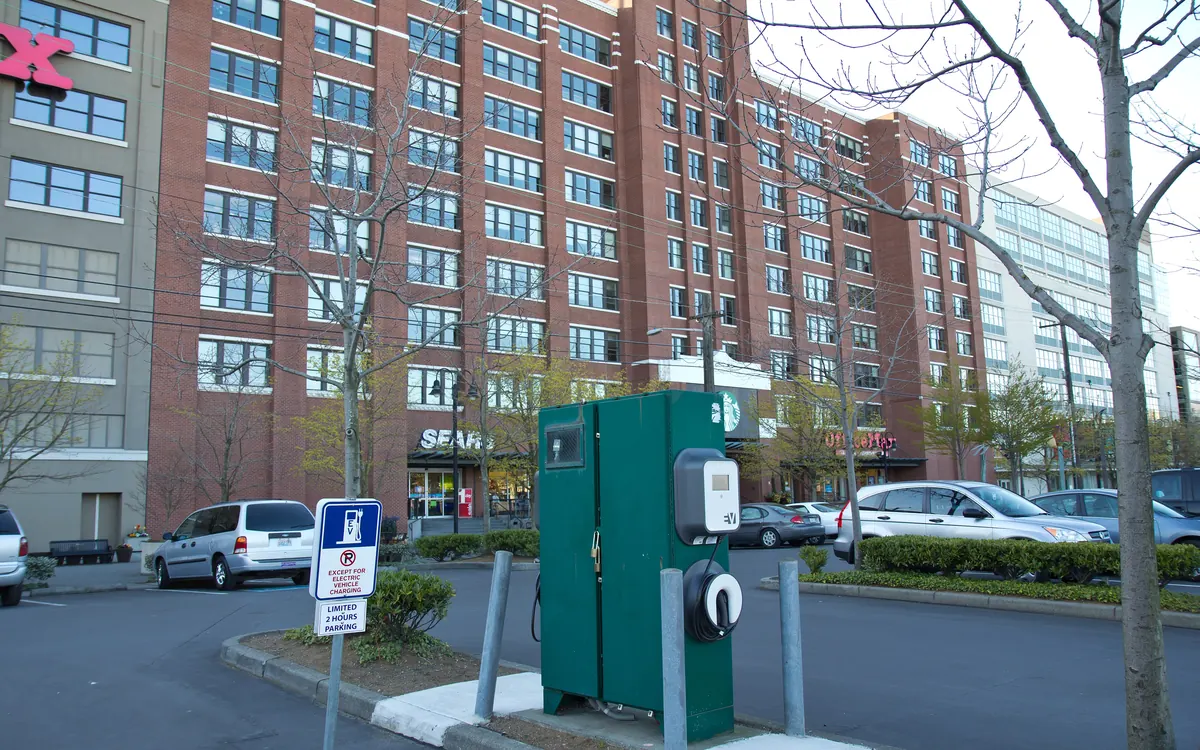
Сіетл до 2030 року встановить до 200 вуличних зарядок для EV
Сіетл пропонує мешканцям самим обрати місця для до 200 нових вуличних зарядок рівня 2 біля багатоквартирних будинків; монтаж — з осені 2027-го до 2030-го.