Скільки відеопам'яті потрібно, щоб запускати ШІ локально
Скільки VRAM потрібно для локальних LLM: проста формула для ваг моделі, квантування й KV-кешу, розібрані приклади та яка відеокарта підходить під яку модель.
Редакція LandGadget · · 6 хв читання
Зміст
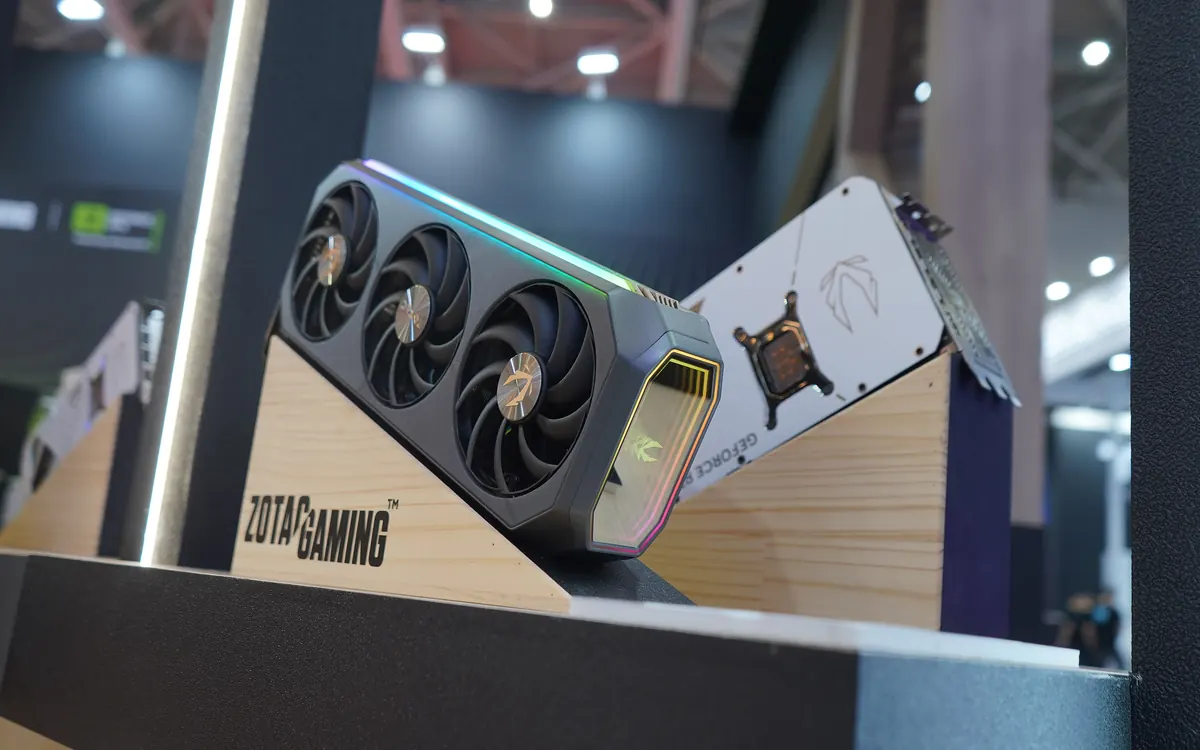
Перше питання перед запуском чат-бота на власному ПК — «а воно влізе?». Для локального ШІ відеопам'ять (VRAM) важить більше майже за будь-яку іншу характеристику: якщо модель уміщається в пам'ять відеокарти, вона працює швидко; якщо ні — повзе або взагалі не завантажується. Ось як порахувати потрібний обсяг за п'ять кроків — на реальних прикладах і без вгадування.
Порахуйте параметри
Розмір моделі видно з назви: Llama 3.1 8B має близько 8 млрд параметрів, Qwen 32B — близько 32 млрд. Кожен параметр — це число, яке має лежати в пам'яті, поки модель працює.
Окремо про моделі mixture-of-experts (MoE). Для кожного токена вони задіюють лише частину параметрів, тому працюють швидко, але завантажити доводиться всі. Наприклад, gpt-oss-20b від OpenAI має близько 21 млрд параметрів загалом і лише близько 3,6 млрд активних на токен. Плануючи пам'ять, рахуйте загальну кількість.
Оберіть точність (квантування)
Моделі навчають у 16-бітній точності, але для домашнього використання зазвичай завантажують квантовану версію, де кожен параметр займає менше бітів. Правило просте: пам'ять для ваг ≈ параметри × біти ÷ 8.
| Точність | На 1 млрд параметрів | Модель 8B | Модель 32B | Модель 70B |
|---|---|---|---|---|
| 16 біт (FP16/BF16) | ≈ 2 ГБ | ≈ 16 ГБ | ≈ 64 ГБ | ≈ 140 ГБ |
| 8 біт (Q8, FP8) | ≈ 1 ГБ | ≈ 8,5 ГБ | ≈ 34 ГБ | ≈ 75 ГБ |
| 4 біти (Q4, INT4) | ≈ 0,55–0,6 ГБ | ≈ 4,5–5 ГБ | ≈ 18–20 ГБ | ≈ 40–43 ГБ |
4 біти — звичайний компроміс для дому: втрата якості для більшості завдань у чаті й програмуванні невелика, а пам'яті потрібно приблизно вчетверо менше, ніж у 16 бітах. Нижче 4 бітів економія більша, але якість падає швидше, особливо в невеликих моделей.
Додайте пам'ять на контекст (KV-кеш)
Генеруючи текст, модель тримає KV-кеш — робочу пам'ять розмови. Він росте з кожним токеном контекстного вікна, і на довгих документах може зрівнятися з розміром самої моделі.
Обсяг залежить від архітектури: 2 × шари × KV-голови × розмір голови × байти на значення — на кожен токен. Два приклади для 16 біт:
- Llama 3.1 8B (32 шари, 8 KV-голів, розмір голови 128): близько 128 КБ на токен. Це приблизно 1 ГБ на 8 тис. токенів, 4 ГБ на 32 тис. і 16 ГБ на повні 128 тис.
- Llama 3.1 70B (80 шарів, 8 KV-голів, розмір голови 128): близько 320 КБ на токен — приблизно 2,5 ГБ на 8 тис. і 10 ГБ на 32 тис.
Тому виробник відеокарт може казати, що моделі 8B із контекстом 128 тис. потрібна карта на 32 ГБ, хоча сама 4-бітна модель важить менше 5 ГБ. Якщо величезні документи вам не потрібні, обмежте контекст у застосунку (Ollama, LM Studio й llama.cpp це дозволяють) — і заощадите чимало пам'яті. Багато інструментів також уміють зберігати KV-кеш у 8 бітах, що вдвічі зменшує його.
Залиште запас
Додайте 10–20% зверху на середовище виконання, тимчасові буфери, а на настільному ПК — ще й на те, що вже займають екран та інші програми. Модель, яка «впритул» влазить на папері, на практиці часто не завантажується.
Якщо пам'яті забракне, інструменти на кшталт llama.cpp можуть винести частину шарів в оперативну пам'ять і на процесор. Модель запрацює, але кожен токен чекатиме на повільнішу пам'ять; ASUS, наприклад, каже, що швидкість інференсу тоді може впасти до 90%. Для знайомства з моделлю це прийнятно, для щоденної роботи — ні.
Підберіть модель під відеокарту
Якщо звести все разом для 4-бітних моделей і помірного контексту близько 8 тис. токенів:
| VRAM | Комфортний розмір моделі | Типові завдання |
|---|---|---|
| 8 ГБ | 7–8B | чат, підсумки, легка допомога з кодом |
| 12 ГБ | до ~14B | краща логіка, довші розмови |
| 16 ГБ | до ~20B, зокрема gpt-oss-20b | сильний універсальний асистент |
| 24 ГБ | ~27–32B | якість, близька до хмарної, для багатьох завдань |
| 32 ГБ | ~32B із довгим контекстом | великі документи, агенти, кілька малих моделей |
| 48 ГБ+ (дві карти або спільна пам'ять) | 70B | найбільші поширені відкриті моделі |
Кілька практичних нюансів:
- Дві відеокарти можуть ділити одну модель у llama.cpp, vLLM та подібних інструментах, тож 2 × 16 ГБ потягнуть те саме, що й 32 ГБ, — лише трохи повільніше за одну карту.
- Спільна (уніфікована) пам'ять у Mac на Apple M-серії та AMD Ryzen AI Max дає GPU змогу використовувати значну частину оперативної пам'яті. Машина на 64 чи 128 ГБ завантажить моделі 70B, які не вмістить жодна споживча відеокарта, хоча генеруватиме повільніше за топовий GPU.
- Підтримка програм важить не менше за гігабайти. CUDA від Nvidia працює майже з усім; карти AMD та Intel уже підтримують llama.cpp, Ollama й інші, але свій улюблений застосунок краще перевірити заздалегідь.
Якщо купуєте залізо саме для цього, наш гід із вибору ноутбука для локального ШІ розповідає про ноутбуки та NPU, а гід із вибору відеокарти — про живлення, габарити й інші характеристики. Тільки починаєте? Почніть із пояснення, що таке відкриті (open-weight) моделі ШІ. Свіжий приклад карти, побудованої навколо пам'яті, — ASUS UGen Arc Pro B70 на 32 ГБ.
Часті запитання
Скільки VRAM потрібно для моделі 7B чи 8B?
У 4 бітах ваги займають близько 4,5–5 ГБ, тож відеокарта на 8 ГБ комфортно запускає таку модель зі звичайним контекстом. У 16 бітах потрібно близько 16 ГБ плюс місце для контексту.
Чи запуститься модель 70B на відеокарті з 24 ГБ?
Повністю — ні. Лише ваги 4-бітної моделі 70B займають близько 40 ГБ. Частину можна винести в оперативну пам'ять, але працюватиме значно повільніше. Практичніше — дві карти по 24 ГБ або комп'ютер із 64 ГБ спільної пам'яті й більше.
Чи рахується оперативна пам'ять як відеопам'ять?
На ПК з окремою відеокартою — ні. Програми можуть переносити шари в RAM, але це набагато повільніше. На Apple Silicon та інших системах зі спільною пам'яттю GPU може напряму використовувати значну частину оперативної пам'яті.
Чому моделі бракує пам'яті на довгих документах?
KV-кеш росте з кожним токеном контексту. Для Llama 3.1 8B це близько 128 КБ на токен у 16 бітах, тобто приблизно 16 ГБ на 128 тис. токенів. Зменште довжину контексту або увімкніть 8-бітний KV-кеш.
Чи вистачить 16 ГБ VRAM для локального ШІ?
Більшості людей — так. Цього вистачає для 4-бітних моделей приблизно до 20 млрд параметрів із нормальним контекстом, а це вже здібні універсальні асистенти й моделі для програмування.
Більше: Комп'ютери та ШІ
Усі →Читайте далі
Рекордний гамма-спалах не згасав 27 днів
Астрономи кажуть, що «двигун» гамма-спалаху GRB 220706A працював близько 27 днів і давав рентгенівські спалахи значно пізніше за будь-які відомі. Що може його живити.
Samsung нібито скорочує випуск Galaxy A на 20%
За даними ETNews, Samsung скорочує виробництво Galaxy A приблизно на 20%, тобто на 10 млн смартфонів, на користь флагманів: пам'ять і чипи з'їдають маржу.
Лідар чи камери для автопілота: що краще?
Лідар, камери чи радар: як працює кожен сенсор безпілотного авто, чому Tesla покладається лише на камери, а Waymo, Mercedes і Rivian R2 додають лідар.